大規模データを活用したヘルスケアデータ分析・活用高度化プロジェクト
課題
POINT 1
近年、国内では公的な医療データベースの整備が進み、悉皆性の高い大規模データを研究や政策の検討に用いる環境が整いつつある。企業内でも、営業記録やコールセンターの稼働ログといったデータが日々蓄積され続けているが、業務の副産物として蓄積されるだけで活用されていないケースは少なくない。生成AIの実用化で期待が高まる一方、「データはある。しかし、そこから何を導けるのかが分からない」という状態にとどまる組織は依然として多い。当社がこれまで関与してきたプロジェクトに共通する課題は、大きく3点に整理できる。
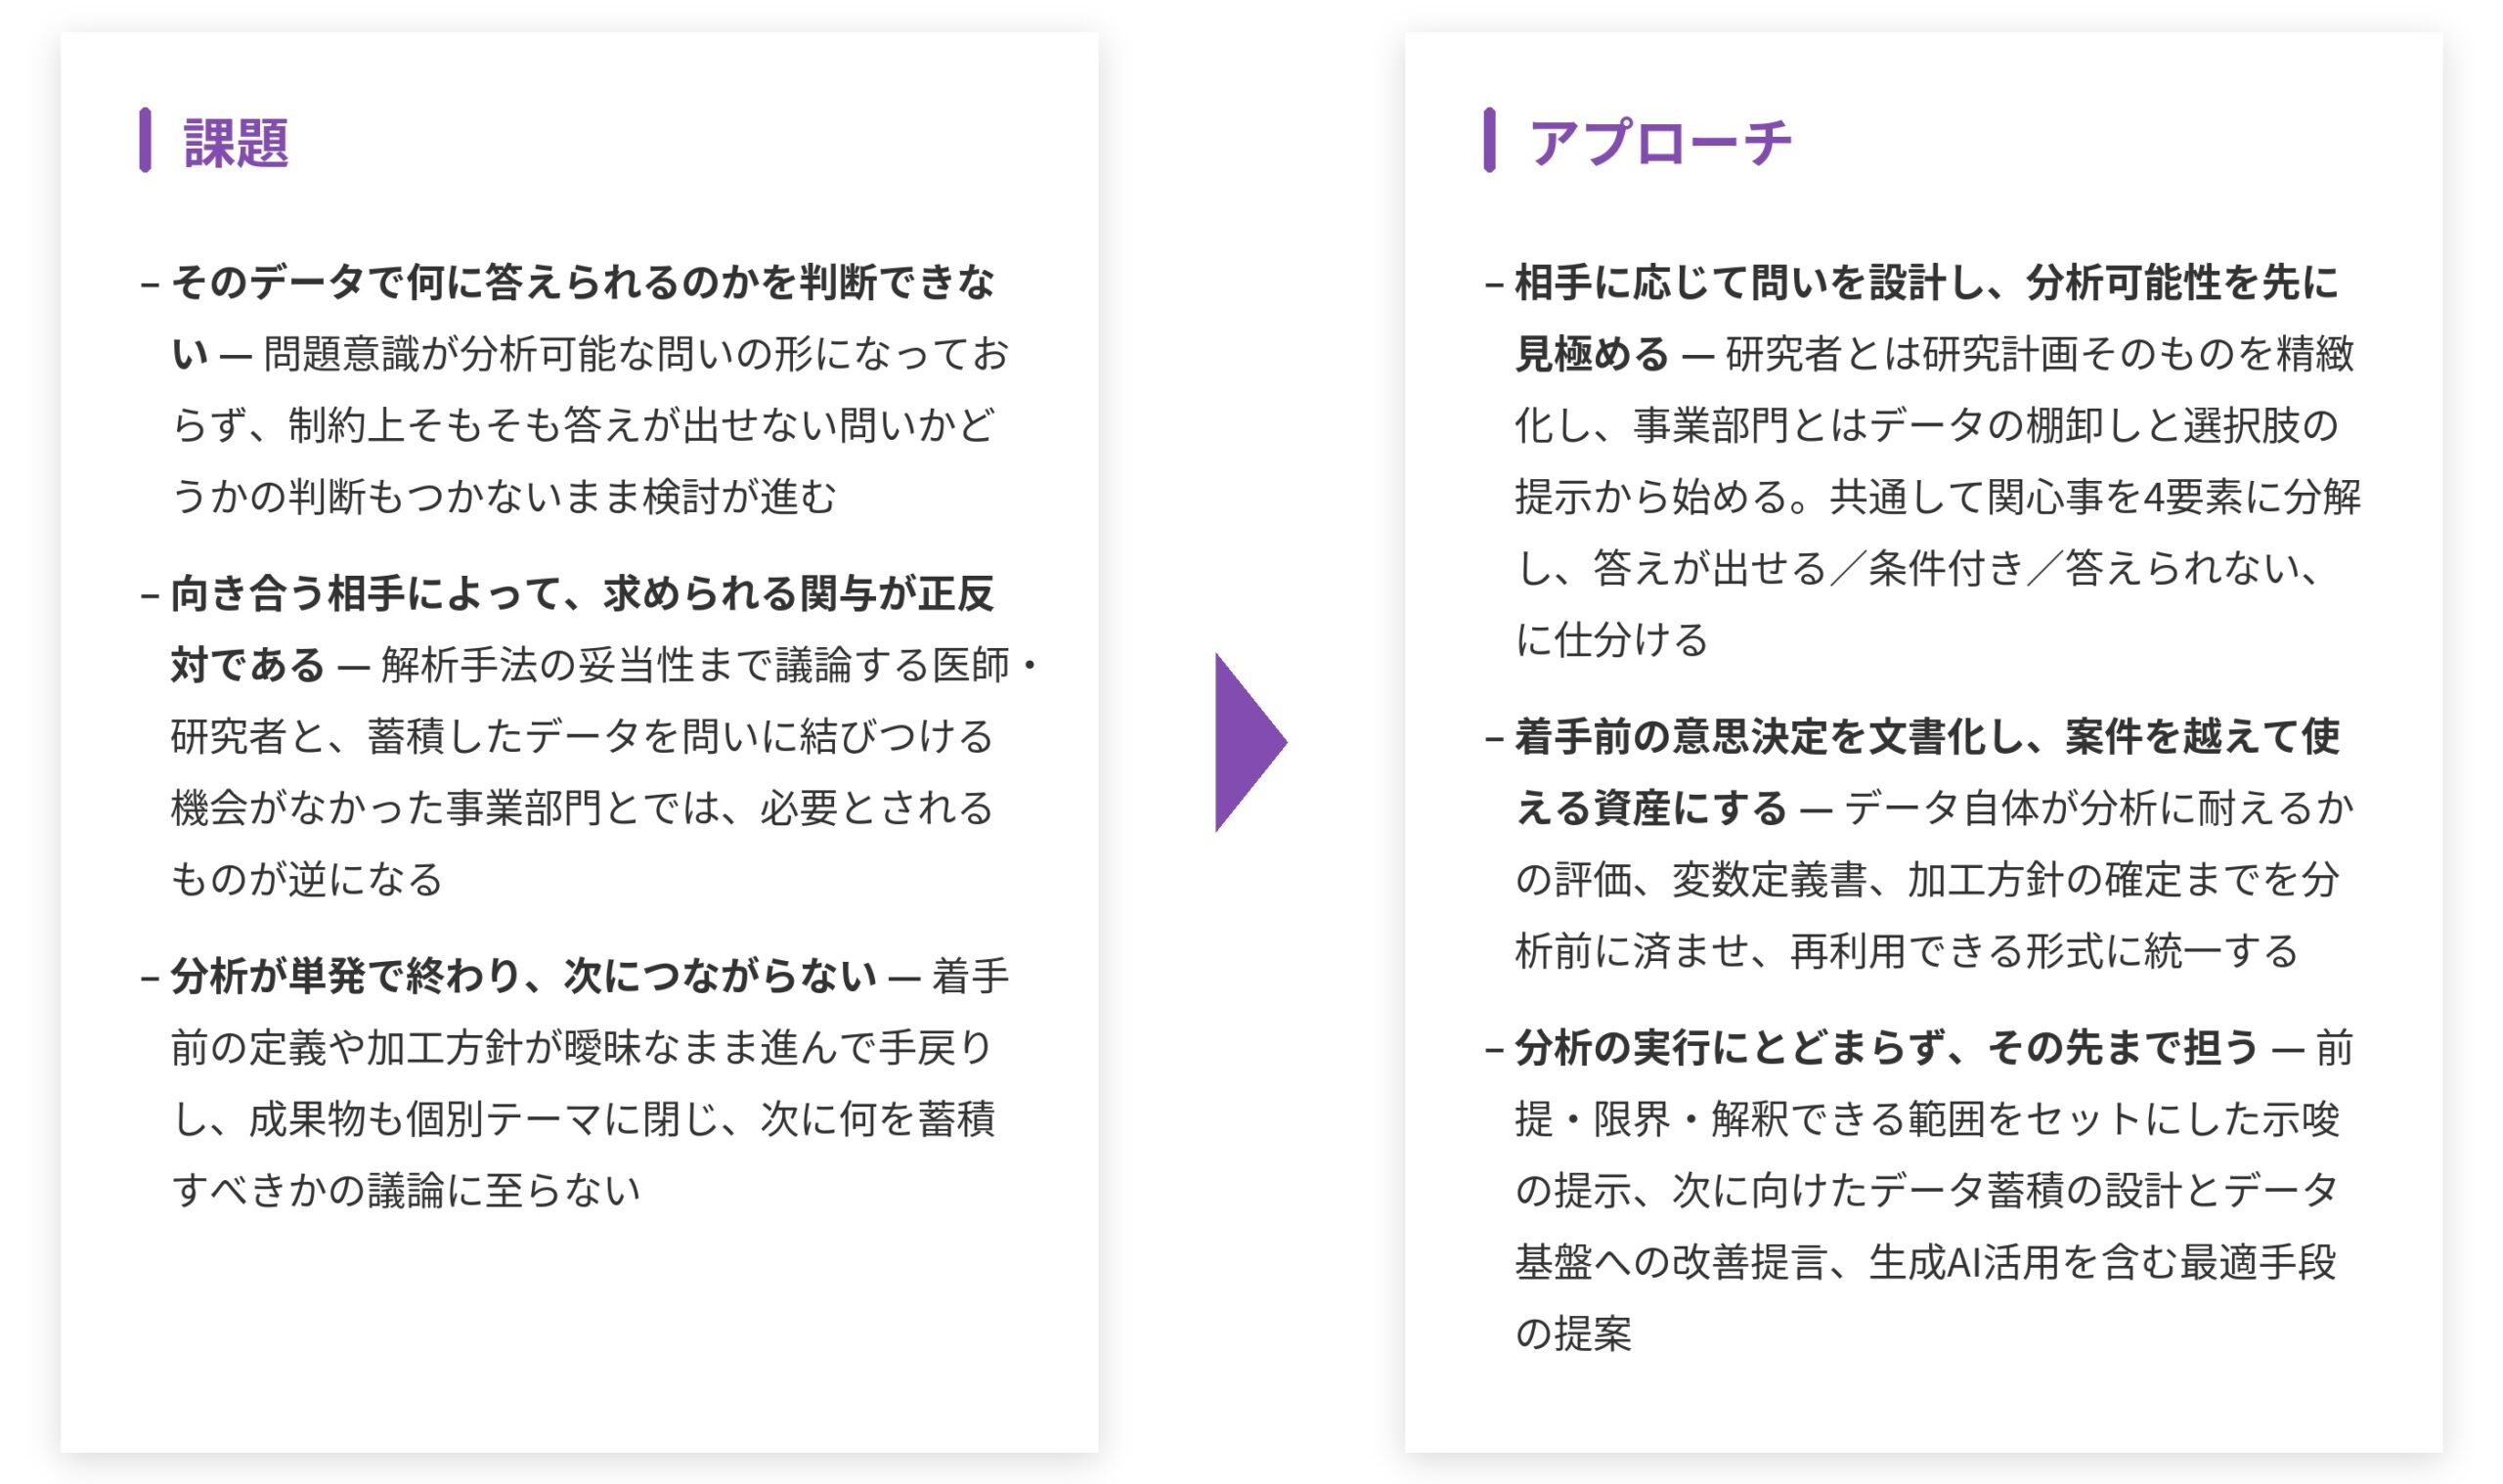
課題1:そのデータで何に答えられるのかを判断できない
問題意識は「○○の実態を明らかにしたい」という粒度で語られることが多く、分析可能な問いの形になっていない。日付情報の粒度や対象を追跡できる範囲といった制約から、そもそも手元のデータでは答えが出せない問いも存在するが、その判断がつかないまま検討が進んでしまう。
課題2:向き合う相手によって、求められる関与が正反対である
ヘルスケア領域には、自ら仮説を立て、交絡の調整や解析手法の妥当性まで踏み込んで議論する医師・研究者がいる。他方には、価値ある大規模データを蓄積してきたものの、それをどのような問いに結びつけられるのかを描く機会がこれまでなかった事業部門がいる。前者には専門家同士として噛み合う議論が、後者には選択肢そのものを示す提案が必要となる。
課題3:分析が単発で終わり、次につながらない
着手前に決めるべき対象の定義や加工方針が曖昧なまま進むため手戻りが繰り返され、成果物も個別のテーマに閉じてしまう。結果として、次にどのようなデータを蓄積すべきかという議論にまで至らない。
当社はこれまで、研究機関や医療機関から事業会社まで、扱うデータもテーマも異なる複数のプロジェクトを横断的に支援してきた。診療報酬制度や臨床実務に関するドメイン知見、大規模データ特有の構造・制約への理解、統計解析・機械学習および生成AIの技術知見、そしてグループが有する実装力を組み合わせ、構想段階から示唆の導出、その後のデータ蓄積・運用設計までを一気通貫で担っている。
アプローチと結果
POINT 2
案件の性質は多様であるが、前述の3つの課題に対する進め方には共通する型がある。
1.相手に応じた問いの設計と、分析可能性の見極め(課題1・2への対応)
研究者が主体となるプロジェクトでは、仮説の妥当性、対象集団の定義、交絡の調整方針といった水準で議論を行い、研究計画そのものを共に精緻化する。分析を専門としない事業部門が相手であれば、まず保有データの棚卸しから着手し、「このデータで何を明らかにできるのか」という選択肢を複数提示するところから始める。
いずれの場合も共通するのは、関心事を対象集団・アウトカム・比較軸・観察期間の4要素へ分解した上で、「その問いは手元のデータで答えられるのか」を先に判定することである。これまでに複数の検討テーマを、答えが出せる問い・条件付きで答えられる問い・このデータでは答えられない問いに仕分け、答えが出せないものには代替となるアプローチを提示してきた。分析できないことを早期に明確にすることもまた、研究資源と投資を守るという意味で重要な成果である。
2.分析着手前に決めるべきことの整理(課題3への対応)
蓄積され続けている企業内データは、業務を回すために設計されたものであり、分析のために設計されたものではない。そこでまず、記録の欠落状況、粒度、時点情報の一貫性、名寄せの可否といった観点からデータそのものを評価し、分析に耐えるかを判断した上で、必要な補修の範囲を定める。
その上で、臨床的な概念をデータ上の変数へ翻訳する。どのような記録の組み合わせをもって対象集団や治療内容を同定するかを定め、判定ロジックを文書化する。定義には感度と特異度のトレードオフが必ず伴うため、主たる定義に加えて代替定義と感度分析の設計まで仕様に落とし込み、対象期間の切り出し方や除外基準、欠測の扱いも事前に確定させる。これらをテーマ横断で再利用できる形式に統一してきたことで、新たな問いが立つたびにゼロから設計し直す状態を脱し、案件を越えて参照できる分析資産として蓄積している。
3.大規模データの分析実行と、相手に届く示唆の導出(課題1・2への対応)
大規模データは、その規模ゆえに処理設計そのものが論点となる。抽出条件の適用順序や中間データの保持方法を含めて設計し、限られた計算資源の下でも再実行可能なパイプラインとして構築する。長期の観察を伴う分析では、利用実績がゼロであることと追跡が途切れていることは意味が異なるため、構造的な非欠測・打ち切り・真の欠測を切り分け、補完の要否と手法を明示した上で結果を提示する。なお、扱うデータは案件によって異なり、公的データを対象とするもの、クライアントが蓄積してきたデータを対象とするもの、グループ各社が保有するデータを対象とするものがそれぞれある。生成過程も制約も異なるため、その違いを踏まえて分析を設計している。
結果を提示する際は、統計量を並べるのではなく、前提・限界・解釈できる範囲をセットで示す。「この結果から何が言えて、何が言えないのか」が共有されて初めて、議論は数字の読み方の確認から、次の意思決定へと移るためである。
4.継続的な活用を見据えたデータ蓄積の設計と、生成AI活用を含む最適手段の提案(課題3への対応)
分析は一度で終わるものではない。当社は各プロジェクトで、その分析に不足していた項目・粒度・取得タイミングを整理し、継続的に検証を回していくために何をどう蓄積すべきかを設計してきた。分析者が本来必要とする粒度と、実際に保有・提供されている粒度とのギャップは実務の中でしか見えてこないため、これをデータ基盤のあるべき姿に関する改善提言としてまとめている。
また、依頼された分析を実行すること自体を目的とせず、クライアントが達成したい状態から逆算して手段を選ぶ姿勢を一貫して取っている。定義候補の洗い出しや関連文献の調査、仕様書のレビューといった工程は生成AIやAIエージェントの活用で大幅に効率化できるため、業務プロセスを工程単位に分解し、AIに委ねる範囲と人が判断すべき範囲を切り分けた活用方針を提案している。
これらの支援を通して、研究を主体とするプロジェクトでは手戻りのない分析計画が組めるようになり、事業部門を対象としたプロジェクトでは、蓄積されるだけだったデータが意思決定に接続され始めている。構築した変数定義書・データ加工仕様は当初の案件を越えて新たな検討テーマへ展開されつつあり、生成AIの活用についても具体的な導入検討が進み始めている。大規模データの活用は、医療の質の向上に直結する社会的意義を持つ取り組みであり、当社は引き続き分析者の目線からその基盤づくりを支援していく方針である。
成功のポイント
POINT 3
・ヘルスケア領域における大規模データ活用が難しいのは、解析手法の高度さゆえではない。研究者と対等に議論できるだけでも、分析を専門としない相手に噛み砕いて説明できるだけでも足りず、その両方を行き来できる人材が介在して初めて、蓄積されたデータは研究成果や意思決定に接続される。
・加えて、性質の異なるプロジェクトを横断的に経験してきたことで、ある案件で得た判断の型が次の案件に活き、支援の再現性が高まっている。データを「与えられるもの」ではなく「あるべき姿を設計するもの」として捉え、依頼した側が自らの手で次の問いを立てられる状態をつくること。それが大規模データ活用の価値を最大化する。